Laya vs LLMs vs BERT
Pergunta O modelo mais novo é a escolha certa para uma tarefa de decisão real?
Laya, modelos BERT e LLMs testados lado a lado na triagem de reclamações de consumidores e na detecção de fraude.
2026 · Projeto pessoal
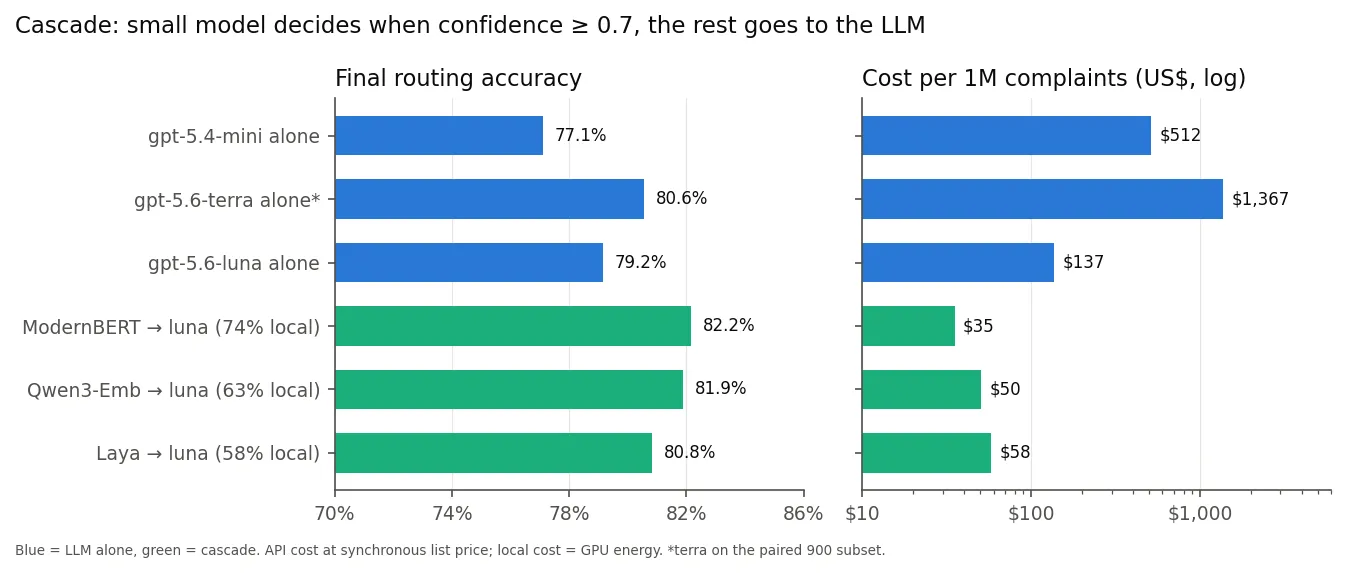
- acurácia, modelo pequeno + LLMo mesmo LLM sozinho: 79,2%
- 82,2%
- por 1 milhão de reclamaçõesmodelo mais caro: US$ 1.367
- US$ 35
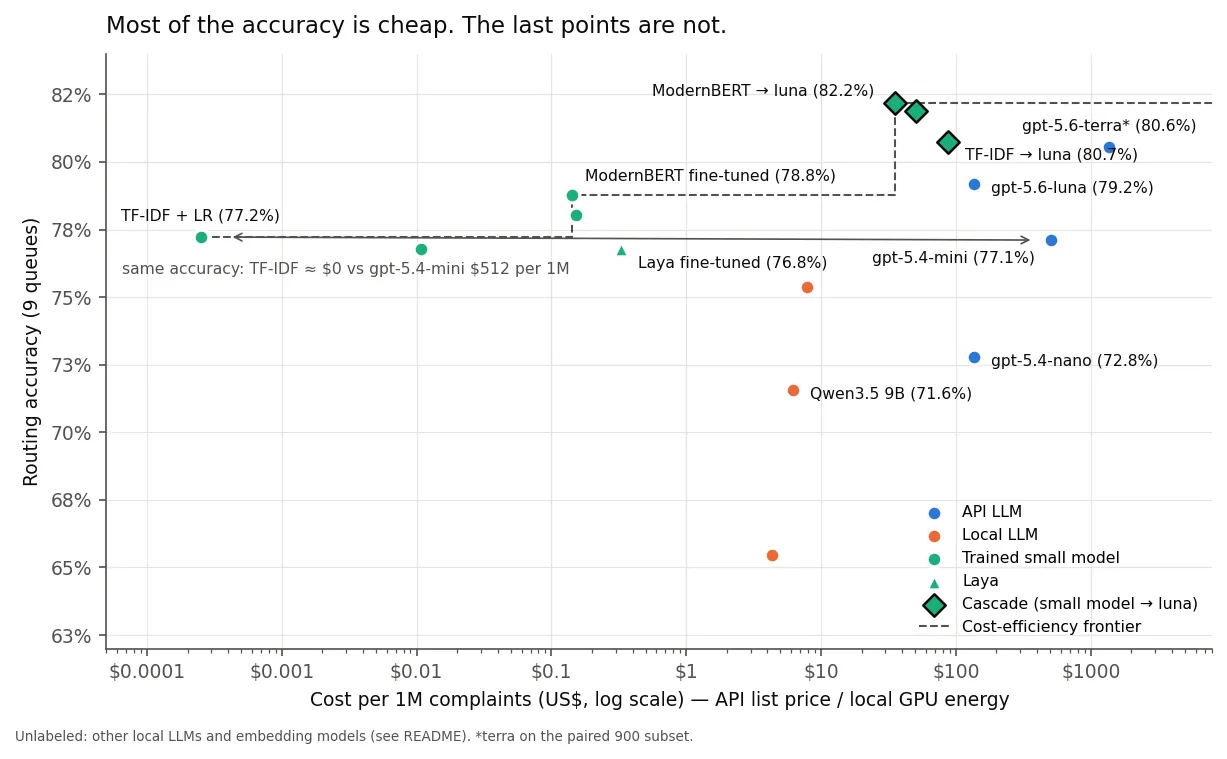
- Laya ajustado45% sem ajuste; gpt-5.4-mini: 77,1%
- 76,8%
- baseline TF-IDFempatou com o gpt-5.4-mini (77,2% vs 77,1%)
- 1 ms
O Laya é a versão open-source do Jev, um modelo “System 1” que toma decisões tipadas com probabilidades calibradas em vez de gerar texto. Aqui ele enfrenta outros 12 sistemas nas mesmas 1.800 reclamações.
Resultados
- Sem ajuste, o Laya não está pronto: 45% de acurácia zero-shot, com probabilidades mal calibradas.
- Ajustado, ele empata com o gpt-5.4-mini (76,8% vs 77,1%), com calibração melhor e latência 12x menor.
- O mais novo não foi o melhor: o ModernBERT, backbone do próprio Laya, ajustado do jeito tradicional chegou a 78,8%, e uma regressão logística com TF-IDF de 20 linhas empatou com o gpt-5.4-mini em 1 ms.
- Os LLMs foram lentos e confiantes demais: cerca de 1 s por decisão; quando o gpt-5.4-mini dizia 97% de chance de fraude, acertava 62% das vezes.
- Combinar modelos deu o melhor resultado: o ModernBERT responde quando está confiante (74% das reclamações) e repassa o resto para o gpt-5.6-luna.
Como foi medido
- 1.800 reclamações de consumidores do mercado financeiro americano (CFPB, base pública), cada uma encaminhada a uma de 9 equipes e checada para relato de fraude; outras 3.600 para treino.
- 13 sistemas: ML clássico, modelos pequenos ajustados, LLMs locais (Ollama) e modelos GPT via API. Versões e preços de setembro e outubro de 2026.
- Acurácia, calibração, latência e custo por milhão de reclamações. Todos responderam às mesmas reclamações, então as comparações são pareadas e testadas estatisticamente.
- Tudo o que rodou localmente usou uma RTX 3060; as chamadas de API do experimento inteiro custaram cerca de US$ 2,20.
Limitações
- Os rótulos são o que o consumidor escolheu num formulário, então o teto fica abaixo de 100%.
- O conjunto de teste é balanceado por equipe e enriquecido de fraude (21,2%), diferente da produção.
- Só inglês, uma divisão e uma semente por modelo, o mesmo prompt para todos os LLMs.
- O Jev em si não foi testado (acesso antecipado).
Outros gráficos
Stack
- Python
- Hugging Face Transformers
- OpenAI API
- scikit-learn
- ModernBERT
- Laya
- Ollama